Conseils aux entreprises
Automatiser la double saisie sans créer de doublons
Connecter deux logiciels ne suffit pas à fiabiliser les échanges. Définissez la donnée de référence, testez les interruptions et prévoyez la reprise avant de supprimer les recopies manuelles.
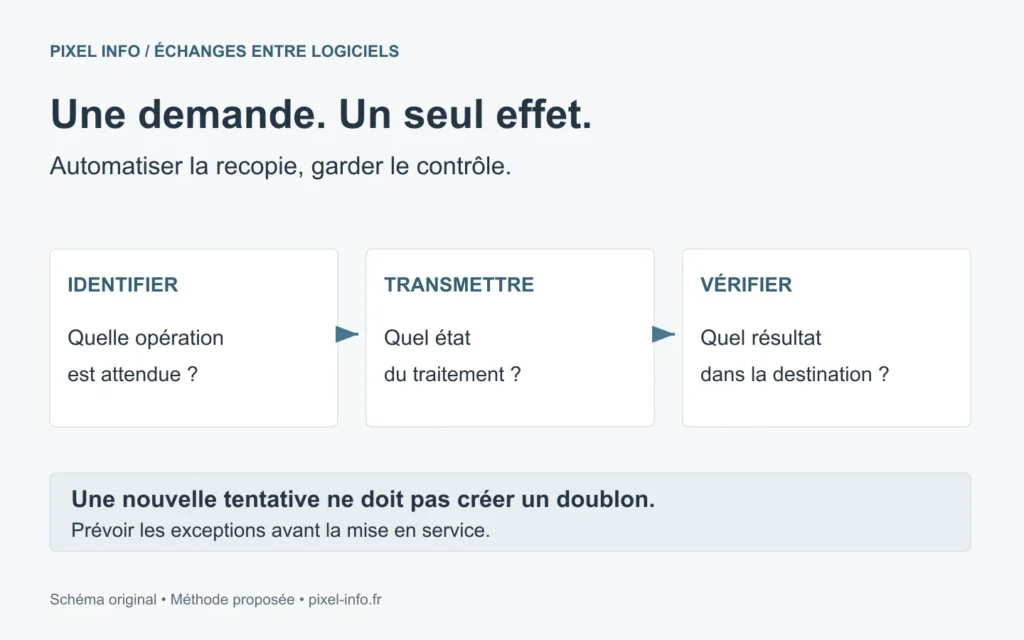
Automatiser la double saisie entre votre site, votre CRM et votre logiciel de gestion peut réduire les recopies. Mais une connexion mal définie peut aussi créer deux dossiers, écraser une correction ou laisser une demande bloquée sans prévenir personne. Le premier sujet n’est donc pas le choix d’un outil : c’est la règle que l’échange doit respecter.
Ce guide s’adresse aux dirigeants et responsables métier qui veulent connecter leurs logiciels existants. Il propose une méthode de préparation et une grille de tests à demander avant la mise en service. Les exemples sont fictifs : ils illustrent des décisions à prendre, pas des résultats obtenus chez un client.
Le repère Pixel Info : une automatisation utile doit permettre de savoir ce qui a été transmis, ce qui reste à traiter et comment reprendre un échec sans refaire une opération déjà réalisée.
Sommaire
- Choisir la première double saisie à automatiser
- Décider quel logiciel fait référence
- Prévoir les doublons et les interruptions
- Tester les cas qui posent problème
- Organiser le suivi et la reprise
- Choisir une solution adaptée au besoin
- Questions fréquentes
Automatiser la double saisie en commençant par un échange précis
Évitez le projet « synchroniser tous nos outils ». Décrivez une opération répétée : recopier une demande validée du site dans le CRM, transmettre une commande acceptée vers la gestion ou récupérer un statut de dossier pour l’afficher dans un portail client.
Observez cette opération sur une période représentative de votre activité. Notez sa fréquence, le temps réellement passé, les corrections nécessaires et les exceptions. Un échange rare mais coûteux à vérifier ne se traite pas forcément comme une recopie fréquente et stable. Le gain attendu doit être comparé au coût de connexion, de surveillance et de maintenance, sans promettre un retour sur investissement avant mesure.
Décrire le déclencheur et le résultat attendu
Dans un exemple fictif, un formulaire crée une demande commerciale. Le résultat attendu peut être un dossier à qualifier dans le CRM, et non une commande ni une facture. Le fait de recevoir une information ne donne pas automatiquement l’autorisation d’exécuter toutes les étapes suivantes.
- Déclencheur : quelle action ou quel statut autorise la transmission ?
- Données : quels champs sont nécessaires et lesquels ne doivent pas circuler ?
- Destination : quel objet doit être créé ou mis à jour ?
- Validation : une personne doit-elle confirmer avant une action engageante ?
- Résultat observable : où voit-on que le traitement est terminé ou bloqué ?
Si ces règles sont encore implicites, notre trame de cahier des charges logiciel aide à les formaliser. La suite de ce guide se concentre sur un point plus précis : la fiabilité de l’échange entre deux systèmes.
Décider quel logiciel fait référence pour chaque donnée
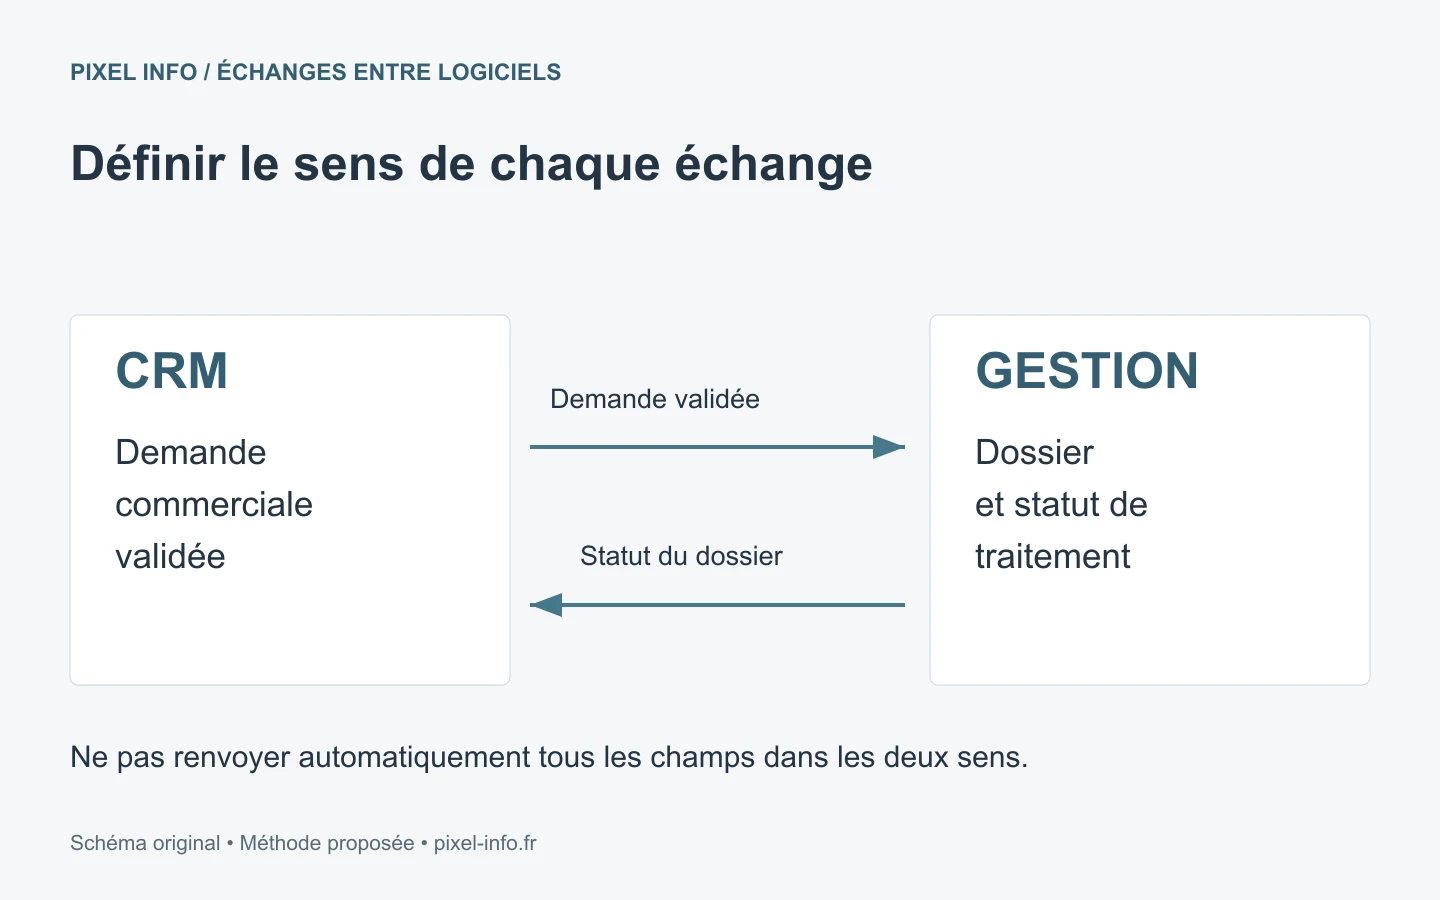
La règle doit être définie champ par champ lorsque c’est nécessaire. Le CRM peut être la référence pour le responsable commercial, tandis que le logiciel de gestion reste la référence pour le statut de traitement. Ce n’est pas une règle universelle : elle dépend de votre organisation.
Demandez une table de correspondance qui précise les champs, les formats, le sens de circulation et la conduite à tenir si une valeur manque. « Synchronisation des clients » ne dit pas ce qui arrive lorsqu’une personne change d’adresse, qu’une entreprise possède plusieurs établissements ou qu’un champ a été corrigé directement dans l’outil destinataire.
Une liaison dans les deux sens n’est pas toujours nécessaire
Si les deux logiciels peuvent modifier le même champ, il faut une règle de conflit. Sinon, une ancienne valeur peut remplacer une correction récente, ou les outils peuvent se renvoyer leurs mises à jour. Pour un premier lot, une transmission dans un seul sens peut être suffisante. Gardez le retour d’information uniquement là où il apporte un usage concret.
Prévoir une demande reçue deux fois ou une réponse perdue
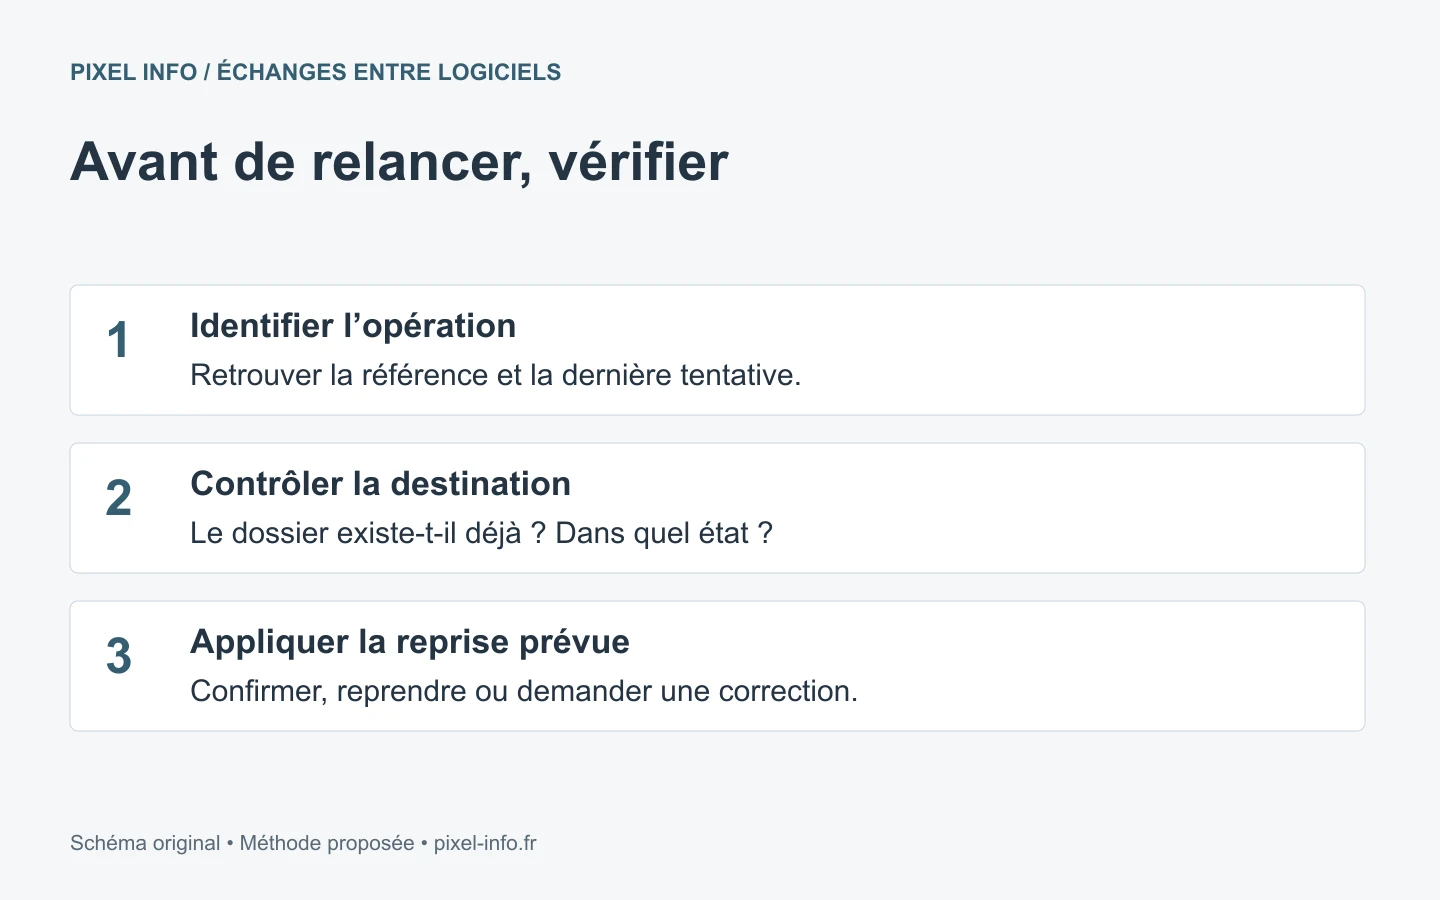
Une interruption réseau peut laisser une situation ambiguë : le système destinataire a peut-être créé le dossier, mais l’émetteur n’a pas reçu sa confirmation. Relancer aveuglément la création risque alors de produire un doublon. Il faut pouvoir reconnaître l’opération, vérifier son résultat et appliquer la procédure prévue.
Le terme technique idempotence désigne ici l’objectif suivant : répéter la même demande ne doit pas créer une seconde fois son effet. La documentation Stripe sur les requêtes idempotentes montre un mécanisme fondé sur une clé d’opération. C’est un exemple de fournisseur, pas une capacité garantie de tous les logiciels. Votre prestataire doit vérifier les possibilités et les limites des API réellement utilisées.
Demandez comment les identifiants source et destination sont reliés. Une adresse e-mail ou un nom ne constitue pas forcément une clé métier fiable : plusieurs dossiers peuvent partager la même adresse, et un nom peut changer. La règle doit distinguer une nouvelle opération d’une nouvelle tentative de la même opération.
Ne pas confondre notification reçue et travail terminé
Un webhook est une notification envoyée par un logiciel lorsqu’un événement survient. La documentation officielle des webhooks Stripe indique notamment que des événements peuvent être reçus plusieurs fois et que leur ordre de livraison n’est pas garanti. Ces comportements doivent être vérifiés chez chaque fournisseur ; un connecteur ne doit pas simplement supposer que tout arrivera une fois, dans le bon ordre.
Pour votre équipe, l’enjeu est de distinguer « notification reçue », « traitement en cours », « résultat confirmé » et « intervention nécessaire ». Une confirmation technique de réception ne démontre pas à elle seule que le bon dossier a été mis à jour avec les bonnes données.
Les tests à demander avant la mise en service
La démonstration d’un cas idéal ne suffit pas. Préparez un jeu d’essai fictif ou anonymisé et faites préciser le résultat attendu pour les situations ci-dessous. N’effectuez pas ces essais sur de vraies commandes ou de vrais destinataires sans dispositif de test adapté.
| Situation à tester | Résultat à vérifier |
|---|---|
| Même demande transmise deux fois | Une seule opération métier est créée ; la répétition est identifiée. |
| Champ obligatoire absent | Le traitement est arrêté ou orienté vers une correction explicite, sans valeur inventée. |
| Réponse interrompue après une création | La procédure vérifie le résultat avant de relancer une création. |
| Logiciel destinataire indisponible | Les échanges en attente restent identifiables ; la reprise est maîtrisée. |
| Mise à jour ancienne reçue tardivement | Elle ne remplace pas sans contrôle un état plus récent. |
| Accès expiré ou limite d’API atteinte | Une alerte exploitable permet d’identifier la cause et la personne chargée d’agir. |
| Correction manuelle pendant l’incident | La reprise tient compte du travail déjà réalisé par l’équipe. |
Cette grille décrit des objectifs de vérification, pas une architecture imposée. Si une API ne permet pas une reprise fiable, le périmètre ou la procédure doit être adapté. Faites également convenir du délai acceptable de synchronisation : une mise à jour toutes les heures et une mise à jour quasi immédiate ne répondent pas au même besoin.
Organiser le suivi sans multiplier les données copiées
Le suivi doit permettre de retrouver une opération, son état, sa dernière tentative et la suite attendue. Une liste d’erreurs sans responsable n’est pas une procédure de reprise. Nommez la personne qui reçoit les alertes, celle qui corrige les données et celle qui peut relancer le traitement. Prévoyez aussi leur remplacement en cas d’absence.
La CNIL recommande pour les API de clarifier les rôles, limiter les données partagées, disposer de journaux pertinents et protéger les clés d’accès. Le suivi n’a donc pas vocation à devenir une copie générale des dossiers clients. Définissez les informations utiles, les accès et leur conservation selon le risque ; ne mettez pas les secrets de connexion dans un tableau partagé ou les messages d’erreur destinés aux utilisateurs.
Pour le lancement, retenez un périmètre pilote et rapprochez les opérations attendues des opérations réellement terminées. Contrôlez les manquants et les doublons, pas seulement le nombre de messages envoyés. Prévoyez une procédure d’arrêt et un mode temporaire de travail, avec une liste des opérations faites manuellement afin de ne pas les répéter au redémarrage.
Connecteur natif, automatisation visuelle ou développement spécifique
Commencez par examiner le connecteur proposé par vos logiciels. Il peut suffire si les objets, les règles et la gestion des erreurs correspondent à votre besoin. Une plateforme d’automatisation visuelle peut convenir à un enchaînement limité. Un développement spécifique devient une option lorsque les règles, les volumes ou les reprises exigent un comportement que les solutions disponibles ne couvrent pas.
Aucune de ces approches n’est fiable par son seul nom. Comparez-les avec la même grille de tests, les limites d’API, les accès disponibles et le suivi prévu. Sans API utilisable, un export/import contrôlé peut parfois être étudié. Évitez de promettre une synchronisation temps réel avant d’avoir vérifié les capacités des outils.
Le chiffrage doit distinguer la connexion initiale, les abonnements ou consommations de services tiers, puis la maintenance des échanges. Notre guide pour comparer les devis de logiciels sur mesure explique comment examiner ces postes sans se limiter au prix de départ.
FAQ sur l’automatisation de la double saisie
Peut-on automatiser la double saisie sans remplacer ses logiciels ?
Oui, si les logiciels proposent des moyens d’échange adaptés et autorisés. Il faut vérifier les API, connecteurs ou formats d’export disponibles, leurs limites et les règles métier attendues. Une étude peut aussi conclure qu’une automatisation n’est pas pertinente.
Une API suffit-elle à éviter les doublons ?
Non. L’intégration doit reconnaître les opérations, relier les identifiants et prévoir les nouvelles tentatives. Les capacités de l’API et la procédure de reprise doivent être vérifiées et testées.
Faut-il synchroniser les données dans les deux sens ?
Seulement si l’usage le justifie. Pour chaque donnée modifiable, définissez le logiciel de référence et la règle en cas de conflit. Une transmission dans un seul sens peut suffire pour un premier lot.
Que faire si une automatisation s’arrête ?
Consultez les opérations en attente et les traces disponibles, identifiez la cause et suivez la procédure de reprise prévue. Avant une relance, vérifiez les opérations déjà réalisées, y compris manuellement. Une relance globale sans rapprochement peut créer des doublons.
Comment mesurer le gain de l’automatisation ?
Comparez une période de référence et une période d’usage représentatives : temps de recopie et de correction, opérations terminées, incidents et travail de surveillance. Le temps libéré n’équivaut pas automatiquement à une économie de trésorerie.
Préparer votre premier échange automatisé avec Pixel Info
Automatiser une recopie ne consiste pas seulement à relier deux champs. Il faut convenir de la donnée de référence, reconnaître les opérations, traiter les exceptions et vérifier le résultat métier. Un premier échange limité et observable permet de tester ces règles avant d’élargir le projet.
Pixel Info propose l’automatisation de tâches et l’intégration d’API, avec étude des possibilités, documentation des flux et suivi des erreurs. Pour discuter de votre projet, indiquez les logiciels concernés, la tâche recopiée et sa fréquence. Un exemple anonymisé suffit pour commencer ; ne transmettez pas de clé API ni de fichier client confidentiel.
Sources consultées le 4 octobre 2026 : documentations Stripe et recommandations CNIL liées dans le texte. Les comportements Stripe cités sont propres à ce fournisseur ; la grille de tests constitue une proposition de méthode à adapter à votre projet.